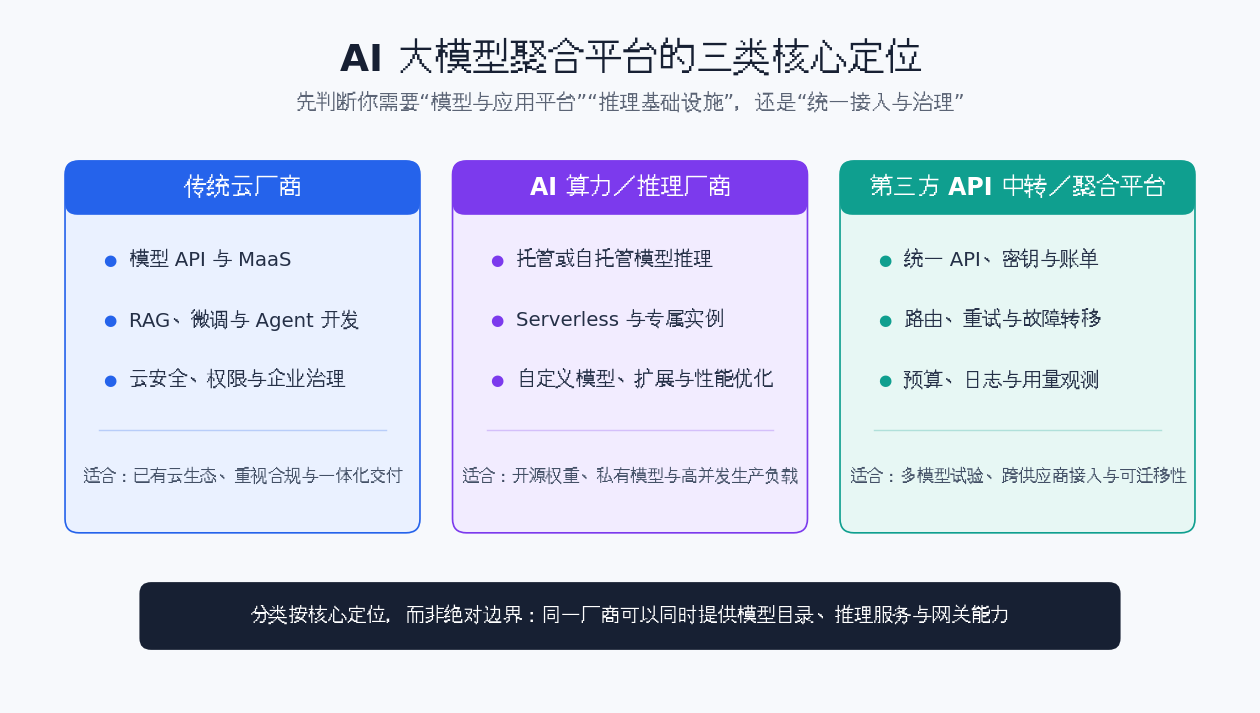
本文将 AI 大模型聚合平台主要分为三类:传统云厂商、AI 算力/推理厂商,以及第三方 API 中转/聚合平台。如果企业需要模型调用、知识库、Agent 开发和权限合规的一体化能力,可优先考察云厂商;如果要部署开源权重或私有模型,并重点优化吞吐、延迟和 GPU 成本,可优先考察推理厂商;如果目标是快速接入多个模型、统一密钥与账单,并保留跨供应商切换能力,第三方网关通常更直接。
如果你正在寻找支持多模型调用的 API 平台,可以从以下 25 个平台开始筛选。传统云厂商包括阿里云百炼、火山方舟、腾讯云 TokenHub、百度千帆、Amazon Bedrock、Google Cloud Gemini Enterprise Agent Platform、Microsoft Foundry、Cloudflare AI Gateway 和 UCloud AstraFlow 星图;AI 算力/推理厂商包括 NVIDIA NIM APIs、无问芯穹、硅基流动、Baseten、Fireworks AI、Together AI、fal、Novita AI、Modal 和 DeepInfra;第三方 API 中转/聚合平台包括 OpenRouter、Vercel AI Gateway、ZenMux、AiHubMix、AI/ML API 和 TokenDance(词元跳动)。
更新日期:2026 年 11 月 11 日。下列模型为代表性示例,并非完整清单。模型目录、价格、速率限制和区域可用性可能随时调整,接入前请查看平台最新文档。三类平台按照核心能力划分,部分产品同时具备云生态、推理部署和 API 网关能力。
一、什么是 AI 大模型聚合平台?
AI 大模型聚合平台,是把一个或多个模型供应商、模型版本或推理资源,通过相对统一的入口提供给开发者和企业的平台。这个入口可以是模型 API、MaaS 控制台、推理 endpoint,也可以是兼容既有 SDK 的网关。常见价值包括减少重复接入、统一认证和计费、集中查看用量、按任务选择模型,以及在供应商故障或限流时执行重试与切换。不过,“聚合”只描述接入和组织方式,并不自动证明平台拥有底层模型、GPU 算力或模型训练能力。
实际选型时,不能把“模型数量”当作唯一标准。一个平台即便提供统一 API,也可能在工具调用、结构化输出、流式响应、上下文缓存和内容审核等细节上存在差异;同样,支持某个模型名称,也不等于所有供应商提供的版本、量化方式、上下文长度和服务等级完全一致。生产环境更需要验证输出质量、首 Token 延迟、持续吞吐、并发限制、数据处理和故障恢复,而不是只确认接口能否返回结果。
三类平台分别解决什么问题?
传统云厂商通常把模型服务放在完整云生态中,除了模型 API,还可能提供 RAG、微调、评测、Agent 开发、身份权限、私有网络和审计能力。它们更适合已经把数据、计算或业务系统部署在相应云上的团队,以及需要企业采购、项目隔离和统一治理的组织。其潜在代价是产品体系较复杂,部分能力与特定云资源绑定,迁移时需要评估的不只是一个 API 地址。
AI 算力/推理厂商更关注模型怎样高效运行,常见交付方式包括 Serverless 推理、专属 endpoint、GPU 实例、私有部署和自托管推理微服务。它们适合开源权重模型、自定义模型、微调后模型和流量较大的生产负载。与单纯中转不同,这类平台通常直接参与模型服务运行、扩缩容和性能优化,因此评估重点会转向硬件、推理引擎、冷启动、自动扩缩容和实例计费。
第三方 API 中转/聚合平台主要解决统一接入与流量治理,常见功能包括统一 API Key、协议适配、模型路由、供应商故障转移、预算控制、日志和成本归因。它们能够降低多模型试验和多供应商维护成本,但也引入了新的中间层。企业应额外核查请求数据经过哪里、日志保存多久、底层供应商是谁,以及平台故障时能否快速切回直连。
二、传统云厂商:模型服务与云生态一体化
这一类平台的优势不只是“能调用哪些模型”,而是模型与云上的数据、身份、网络、安全和应用开发工具能否形成完整链路。对于知识库问答、内部 Copilot、客服 Agent 等需要访问企业数据的项目,这种一体化往往比单独比较 Token 单价更重要。不过,同一云内不同模型、区域和功能可能采用不同配额与计费方式,上线前仍需逐项确认。
1. 阿里云百炼 Model Studio
阿里云百炼 Model Studio 是阿里云的一站式大模型服务平台,既提供模型 API,也覆盖应用开发、知识库和 Agent 等能力。它不仅支持通义千问系列,还接入了 Kimi、DeepSeek、GLM 等模型,适合希望在阿里云内完成模型选择、应用搭建和业务集成的团队,尤其是已经使用阿里云身份、数据与计算资源的用户。
代表模型(非完整清单):qwen3.8-max、qwen3.8-flash、qwen3.7-plus、Kimi K3.1 Pro、Kimi K3、DeepSeek V4.1 Flash;此外还包括 GLM 等第三方模型。完整目录与版本状态见(阿里云百炼模型列表)。
选型时,应把百炼放在“云上 AI 应用平台”而非单纯中转站的语境中评估。除了目标模型是否可用,还要检查所需区域、API 协议、RAG 或 Agent 组件、权限隔离和日志能力是否匹配现有架构。如果业务系统已经在阿里云,减少跨云数据传输和统一采购可能是实际收益;如果核心业务多云分布,则应提前设计模型抽象层和出口方案。
2. 火山方舟
火山方舟是火山引擎面向大模型服务与应用开发的平台,提供模型调用、工具使用和相关应用构建能力。对于已经在火山引擎上承载内容、数据或应用业务的团队,它可以作为模型接入与应用开发的一体化入口。评估时不应只关注模型清单,还应把多模态需求、工具调用、应用编排和云上资源的协同方式一起纳入测试
代表模型(非完整清单):Doubao Seed 2.1 Pro、Doubao Seed 2.1 Lite、Doubao Seedance 2.5、Doubao Seedream 5.0 Pro、DeepSeek V4.1 Flash、Kimi K2.8 Preview,覆盖文本、视频与图像生成等任务;实际可用版本见(火山方舟模型列表)。
火山方舟更适合希望从模型试验走向完整应用交付的团队,而不是只需要替换一个 Base URL 的轻量场景。建议用真实业务样本验证输出质量、响应稳定性和工具链路,并确认所使用的模型版本、上下文、并发和限流策略。若未来存在跨云或多供应商需求,可以在业务代码与平台 SDK 之间保留适配层,避免把平台专属参数散落在核心逻辑中。
3. 腾讯云 TokenHub
腾讯云 TokenHub 的突出特征是多模型聚合接入,官方文档明确涉及对 OpenAI Chat Completions 与 Anthropic Messages API 的兼容支持。这类协议兼容有助于降低既有应用的改造成本,也为使用不同模型生态的团队提供统一入口。它适合已经使用腾讯云服务,或希望在腾讯云账号与采购体系内集中管理多模型调用的用户
代表模型(非完整清单):Hy4、Hy4 Preview、DeepSeek V4.1 Flash、DeepSeek V4 Pro、GLM-5.3、GLM-5.3-Flash、Kimi K3.1 Pro、MiniMax-M3.1-Flash、Qwen3.5-Plus;具体模型 ID、上下文与接口能力见(腾讯云 TokenHub 模型列表)。
不过,协议兼容不等于所有请求字段和模型行为完全一致。接入前应测试流式输出、工具调用、结构化结果、错误码、重试和用量统计,尤其要确认现有 SDK 的高级功能是否可用。对生产系统而言,还应核实底层模型提供方、请求处理区域、日志策略与服务等级,而不能仅凭“兼容 OpenAI/Claude”就认定可以无风险替换。
4. 百度千帆
百度千帆当前的官方定位已覆盖大模型服务、RAG 与 Agent 开发等能力,更适合作为企业构建 AI 应用的云平台来理解。对于需要把模型、知识检索和应用流程结合起来的团队,千帆的价值在于提供相对完整的开发路径,而不只是给出现成模型的调用接口。
代表模型(非完整清单):ERNIE 5.1、DeepSeek V4.1 Flash、Qwen3 系列、Qianfan-VL 等。模型版本和可用接口会随目录更新,接入前应查阅(百度千帆模型文档)。
选择千帆时,建议先明确项目需要的是模型 API、知识库问答,还是可持续运行的 Agent,再判断对应组件是否必要。如果仅调用一个稳定模型,完整平台可能带来额外学习与配置成本;如果需要企业数据接入、权限和应用治理,一体化组件则可能减少自建工作。无论哪种情况,都应把数据权限、引用可追溯性、评测集和上线后的监控纳入方案。
5. Amazon Bedrock
Amazon Bedrock 也常被称作 AWS Bedrock,是 AWS 提供的托管式基础模型服务。它把多供应商模型访问与 AWS 的安全、治理和应用构建能力结合起来,适合已经在 AWS 上运行数据与业务系统、希望通过统一云环境使用不同模型的团队。
代表模型(非完整清单):Amazon Nova 2 Lite、Claude Sonnet 5.5、Claude Opus 5.5、Kimi K3.1 Pro Highspeed、GPT-6.1 Sol、Grok 4.7。它们来自 Amazon 及不同模型供应商,并非 AWS 全部自研;区域、账户权限和推理配置以(Amazon Bedrock 模型目录)为准。
Bedrock 的选型重点应从“模型是否上架”进一步延伸到区域可用性、模型访问权限、吞吐模式、私有网络、日志和成本分摊。不同模型的能力和计费选项可能不同,不能假设同一区域内所有功能都可互换。对跨国业务,还要把数据驻留和跨境调用路径写进架构审查;对高可用业务,则需要明确故障时切换到哪个模型或区域,以及切换后质量是否仍可接受。
6. Google Cloud Gemini Enterprise Agent Platform(原 Vertex AI)
Google Cloud 已将原 Vertex AI 的相关能力纳入 Gemini Enterprise Agent Platform,重点覆盖企业 Agent 的构建、扩展、治理和优化。在部分文档与控制台中,仍可能看到 Vertex AI、Vertex AI Studio 和 Model Garden 等名称。该平台面向开发者与数据团队,与员工直接使用的 Gemini Enterprise 应用并不是同一产品。
代表模型(非完整清单):Gemini 4 Argon、Gemini 3.8 Flash、Gemini 3.5 Flash-Lite、Gemma 4、Claude Sonnet 5.5、Veo 3.1 Lite。除 Google 自有模型外,Model Garden 还包含合作伙伴与开放模型;版本生命周期和区域可用性见(Google Cloud 模型版本文档)。
该平台适合已经采用 Google Cloud 数据、机器学习或 Agent 技术栈的团队。选型时应分别核查模型访问、自定义训练或调优、Agent 运行时、评测与治理是否属于项目必需项,并查看具体模块的当前文档。对于既有 Vertex AI 用户,产品更名不代表可以忽略版本迁移;应以各服务的 release notes 为准,检查 SDK、端点、模型版本和停用计划,而不是仅替换产品名称。
7. Microsoft Foundry(原 Azure AI Foundry)
Microsoft Foundry 是原 Azure AI Foundry 的当前名称,微软官方文档已明确说明这一命名关系。平台围绕模型、Agent、工具、监控、评测和企业治理提供统一体验,适合深度使用 Azure、Microsoft Entra 及企业安全体系的组织。相较于只提供模型转发的服务,它更接近一个覆盖 AI 应用开发与运营的控制平面。
代表模型(非完整清单):GPT-6.1-Sol、GPT-6.1-Terra、GPT-5.4、Claude Opus 5、Claude Sonnet 5、Grok 4.7、Kimi K2.7 Code、Llama-3.3-70B-Instruct。不同模型的销售方式、部署类型与区域支持可能不同,详见(Microsoft Foundry 模型文档)。
采用 Microsoft Foundry 时,应把 RBAC、网络、策略、项目隔离和监控纳入初始设计,而不是上线前才补做。它的优势通常在企业治理和生态协同,但这也意味着需要理解相应的云资源结构与权限模型。对已有 Azure OpenAI 或旧版 Azure AI Foundry 项目的团队,建议逐项核对当前服务名称和资源依赖,避免把品牌升级误解为所有旧配置自动获得相同能力。
8. Cloudflare AI Gateway
Cloudflare AI Gateway 更准确的定位是 AI 请求网关与治理层,而不是传统意义上以模型目录为中心的 MaaS 平台。官方功能页列出了缓存、支出限制、速率限制等能力,说明它更适合放在应用与模型供应商之间,用于观察、控制和优化请求。如果团队已经使用 Cloudflare 的网络与开发者服务,这种部署方式具有较强的架构连贯性。
可接入的上游模型示例:DeepSeek V4 Pro、Kimi K2.7 Code、GPT-OSS-20B、Qwen3.8-27B、GLM-5.2、Claude Opus 5、Gemini 3.8 Flash、MiniMax M3。这些名称来自统一接口或 Auto Router 文档示例,实际取决于所连接的供应商或 Workers AI,并非 Cloudflare 自研的固定模型目录(Cloudflare Auto Router)。
把 Cloudflare AI Gateway 纳入“聚合平台”清单,是因为它能统一治理多个 AI 请求入口,但用户不能据此默认平台会代替自己提供所有模型或算力。选型时应确认直连供应商、BYOK 或其他接入方式是否符合设计,并测试缓存语义、流式请求、日志字段和故障行为。对于涉及敏感数据的请求,还要明确网关上保存了什么,以及哪些控制仅作用于流量管理而非模型本身。
9. UCloud AstraFlow 星图
UCloud AstraFlow 星图官方页面强调一个 API Key、OpenAI 兼容,以及对语言、图像和视频等模型类型的覆盖,符合多模型统一接入平台的基本特征。它适合希望在国内云服务体系中简化多模型调用,同时兼顾文本与生成式媒体需求的开发者。与只提供单模态模型目录的平台相比,多模态覆盖是其评估时值得单独验证的方向。
代表模型(非完整清单):文本侧包括 DeepSeek V4、Qwen3.7、GLM-5.3-Flash、Kimi K3、MiniMax-M3、豆包、文心一言等;生成式媒体侧包括 Seedream、Vidu、可灵等模型家族。当前模型与模态以(UCloud AstraFlow 星图)为准。
实际接入不能只检查文本 Chat Completions 是否可用。图像和视频任务通常还涉及异步任务、结果轮询、文件存储、内容审核和不同的计费单位,这些流程未必能沿用文本模型代码。建议按模型类型分别做技术验证,并确认区域、配额、文件保留、失败任务计费和售后支持,避免把“统一 Key”误解为“所有模态共用完全相同的调用逻辑”。
三、AI 算力/推理厂商:重点解决模型运行与部署
这类平台与 API 网关最大的区别,是它们通常直接参与模型推理服务的运行。用户可以选择平台已经托管的模型,也可以部署开放权重、私有 checkpoint 或自定义服务,并根据流量选择 Serverless、专属实例或自托管方案。其核心价值在于把模型、推理引擎和硬件组合成可调用的生产服务,而不是仅仅把第三方请求转发到另一个供应商。
因此,推理厂商的对比不应停留在 Token 单价。Serverless 适合流量不稳定、希望按调用付费的项目;专属部署更适合持续高负载、私有模型或对资源和延迟有更明确要求的服务。测试时要同时记录吞吐、首 Token 延迟、每 Token 延迟、冷启动、并发和失败率,并用相同模型、精度、上下文与输出长度比较,否则结果很容易失真。
10. NVIDIA NIM APIs
NVIDIA NIM 的核心是经过优化的推理微服务与标准化 API。官方资料同时体现了两种使用路径:通过托管 endpoint 体验或评估,以及将 NIM 容器部署到由 NVIDIA 加速的基础设施中。它更适合希望控制模型运行环境、推理栈和部署位置的企业,而不应被简单理解为一个只负责转发闭源模型请求的聚合网关。
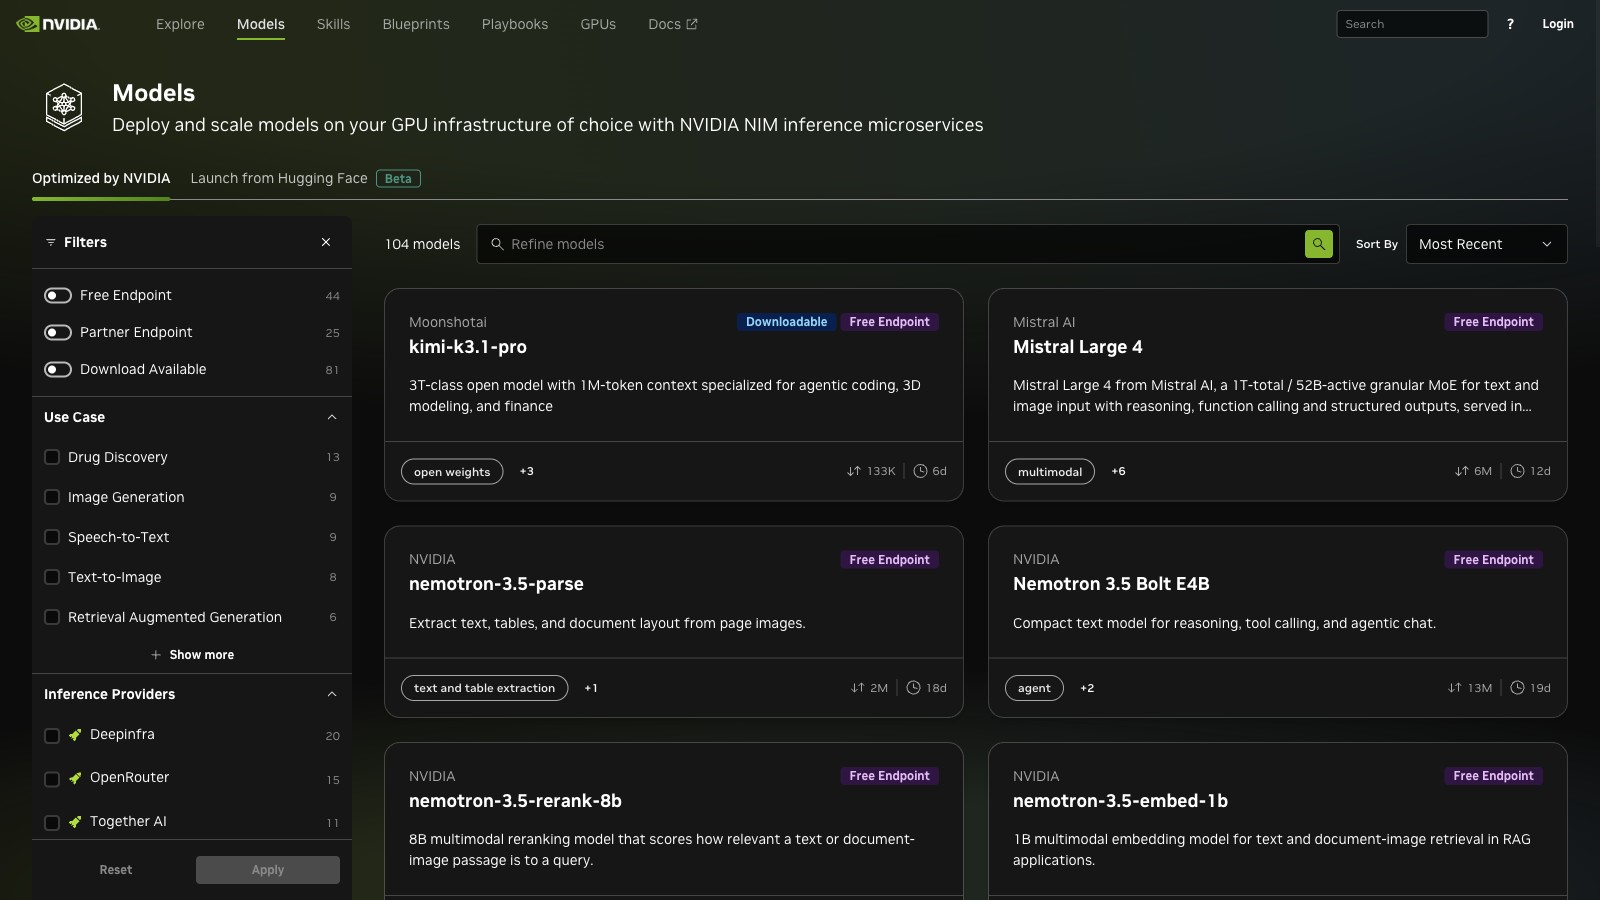
官方支持模型示例:DeepSeek V4.1 Flash 1017、Kimi K3.1 Pro、MiniMax M3.1 Flash、Mistral Large 4、Qwen3.5-122B-A10B、GLM-5.3,以及 Nemotron 系列。这里的“支持”指 NIM 微服务或推理配置支持,具体可用性受 NIM 版本、GPU、精度和部署方式影响,详见(NVIDIA NIM 支持矩阵)。
选择 NIM 时,应先确认目标模型是否有对应微服务、所需 GPU 与驱动条件、部署方式和许可要求。自托管能够带来环境控制,但也意味着团队需要承担容量、监控、升级和故障处理等责任;托管体验则不代表生产架构可以直接照搬。对已有 Kubernetes 或私有 GPU 资源的企业,NIM 值得作为标准化推理层评估,但最终收益仍需通过真实模型和负载测试确认。
11. 无问芯穹
无问芯穹的核心定位是 AI 原生基础设施,产品体系包括面向异构算力的 Agentic Infra 与面向大模型服务的 Agentic MaaS。其差异化重点在于把多元芯片、算力调度、模型训练或推理与企业场景结合,因此更适合按企业级基础设施与 MaaS 方案评估,而不是仅按个人开发者的模型中转站理解。
主要模型家族(非完整清单):DeepSeek、GLM、Kimi、MiniMax、Qwen。具体模型版本、精度和部署方式需要结合项目需求确认,可通过(无问芯穹 Agentic MaaS)了解其模型服务与适配方向。
对需要国产或多元异构算力、私有化方案和行业交付的组织,无问芯穹的可考察价值主要在软硬件协同与资源组织。采购前应明确算力来源、部署边界、模型适配范围、迁移方式和服务等级,并把商务支持纳入评估。个人或小团队则不宜默认其所有服务都按通用自助 API 开放,应先确认当前账户类型、计费方式和服务范围,再决定是否投入接入。
12. 硅基流动 SiliconFlow
硅基流动 SiliconFlow 提供模型 API、专属实例、推理加速和私有化部署等能力,既适合直接调用托管模型的开发者,也覆盖对资源和部署方式有更高要求的企业场景。它常被用于开源或开放权重模型的 API 接入,选型时可以直接在模型目录中查看当前可用的模型、模态和调用方式。
官方文档中的模型示例:Qwen/Qwen3-32B、DeepSeek-V3、GLM-4.6、BAAI/bge-m3、Qwen3-Embedding-8B、Qwen-Image、Kolors、SenseVoiceSmall,覆盖文本、向量、图像与语音任务。示例不等于当前完整托管清单,实时可用模型应查阅(SiliconFlow 模型广场)及(官方集成文档)。
如果项目处于原型期,可以先通过托管 API 验证模型质量和调用链;当流量、数据边界或稳定性要求提高后,再评估专属实例或私有部署是否必要。需要特别核对相同模型在不同服务形态下的版本、量化、上下文和吞吐差异,同时测试限流、流式输出、工具调用与用量统计。低成本调用和稳定生产服务是两个相关但不完全相同的目标。
13. Baseten
Baseten 是面向模型推理与训练的平台,官方文档提供托管 Model APIs、在专属基础设施上部署自有模型,以及训练后服务化等路径。其托管接口支持常见的兼容调用方式,而专属部署允许团队控制模型、硬件、扩缩容和发布生命周期。因此,它既可用于快速调用开放模型,也更适合自定义模型进入生产后的持续运营。
部署与引擎支持示例:Llama-3.3-70B-Instruct、Qwen3-235B-A22B-Instruct、Mistral-Small-24B-Instruct、GPT-OSS-20B、Gemma-3-27B-it。这些示例用于说明可部署或引擎适配范围,不等同于所有模型都可通过托管 Model APIs 直接调用;完整支持方向见(Baseten Engines)。
选型时首先要区分按模型 API 调用与运行专属部署,两种模式的成本结构和运维责任不同。后者需要关注副本数量、缩容到零、冷启动、最小运行资源和发布策略,不能只用一次请求的 Token 价格估算月度账单。对于已经微调模型或需要私有 checkpoint 的团队,Baseten 的部署控制更有吸引力;对于只使用闭源模型的应用,则要先确认其目录是否满足需求。
14. Fireworks AI
Fireworks AI 官方文档覆盖 Serverless、Deployments、Training 和模型 API 等产品路径,并涉及函数调用、结构化输出与批量推理等开发能力。它适合围绕开放模型开展推理、微调和生产部署的团队,尤其是那些希望先从按需调用开始,再视流量与控制需求升级到专门部署的项目。
代表模型(非完整清单):DeepSeek V4.1 Flash 1017、Kimi K3.1 Pro、GLM 5.3、MiniMax M3、Qwen3.7 Plus、Step 3.7 Flash、Qwen3 Omni 30B A3B Instruct。具体模型可采用的服务形态与功能以(Fireworks AI 推荐模型)为准。
评估 Fireworks AI 时,建议把模型质量和推理性能分开测试:质量测试确认模型版本与任务适配,性能测试确认负载下的延迟和吞吐,功能测试则验证工具调用、JSON 约束及批处理流程。对于需要长期运行的业务,还要比较 Serverless 与部署模式的总成本,并检查扩容、区域、日志和数据政策。不要仅凭同一模型名称,就假设不同推理服务商的输出与延迟完全一致。
15. Together AI
Together AI 主要面向开放权重模型的推理、微调和部署,提供 Serverless 模型访问以及向专属服务扩展的路径。它适合希望使用开放模型生态、减少自建推理基础设施,并在后续保留调优或部署空间的开发团队。由于模型目录与服务形态会持续变化,具体模型是否支持 Serverless、微调或专属部署,应以当前文档逐项确认。
代表模型(非完整清单):文本与推理模型包括 DeepSeek V4 Pro 0813、DeepSeek V4.1 Flash、Kimi K3.1 Pro、MiniMax M3.1 Flash、GPT-OSS 120B、Qwen3.7 Plus;媒体与语音模型包括 FLUX.2、Seedream、Seedance、Kokoro 82M、Whisper Large V3。Serverless 可用范围见(Together AI 模型文档)。
在实际选型中,Together AI 的比较对象通常不是纯 API 中转站,而是其他开放模型推理平台。建议围绕同一模型和任务测试输出、延迟、上下文、工具能力与限流,再计算不同流量曲线下的成本。如果未来计划使用微调权重,应提前确认微调产物能否导出、部署到何处,以及是否支持从试验环境平滑进入生产,以降低后续迁移风险。
16. fal
fal 更聚焦于生成式媒体推理,官方定位覆盖图像、视频、音频和 3D 等模型,并支持自定义 Serverless 部署。它适合 AI 绘图、视频生成、数字人、音频处理和多模态创意产品,而不是仅以文本大模型聊天为中心的项目。对于需要频繁试验不同生成模型、又不愿自行管理 GPU 推理环境的团队,fal 提供了更贴近媒体工作流的入口。
代表模型(非完整清单):FLUX 3、Krea 3 Text to Image、Kling 4.0 Image to Video、MiniMax H3 Max Text to Video、Seedance 2.5 US Image to Video。由此也可看出,fal 的目录重点在图像和视频等生成式媒体,而非文本聊天模型;完整目录见(fal Models)。
生成式媒体平台的成本与文本 Token 不能直接比较。选型时应按每次生成、时长、分辨率、计算时间或平台当前规定的计费单位拆解成本,同时测试排队时间、失败重试、异步通知和产物存储。对于视频等长任务,还要确认任务状态、超时、Webhook 和文件 URL 的生命周期。若涉及用户上传素材,应额外核查输入与输出文件的留存和访问控制。
17. Novita AI
Novita AI 提供多模态模型 API、专属 endpoint、GPU 服务和 Agent Sandbox 等产品。官方文档把通用模型调用与专属部署区分开来,因此它既可用于接入现成模型,也可面向需要独立资源和更明确容量配置的业务。Agent Sandbox 则说明其产品范围已延伸到 Agent 执行环境,而不只是传统文本模型 API。
代表模型(非完整清单):GLM 5.3 FlashX、GLM 5.3 Flash、Kimi K3.1 Pro、MiMo V2.6 Flash、DeepSeek V4.1 Flash、Qwen3.8 Flash、Qwen3.8 Max;具体接口、模态和版本以(Novita AI 模型目录)为准。
选择 Novita AI 时,应先判断自己需要的是模型目录、专属推理、GPU 资源还是沙箱执行,避免把不同产品的能力和价格混为一谈。对多模态项目,需要分别验证文本、图像、视频等 API 的同步或异步模式;对 Agent 项目,则要检查沙箱隔离、生命周期、文件处理和网络权限。生产环境还应测试限流与故障行为,并明确日志及生成内容的保存策略。
18. Modal
Modal 是代码优先的 Serverless AI 计算平台,更适合被理解为运行自定义推理、训练、批处理和沙箱任务的基础设施,而不是以现成模型目录为核心的聚合平台。开发者可以把代码和依赖部署为弹性服务,由平台处理底层计算资源。它适合拥有一定工程能力、需要自定义预处理与后处理,或希望精细控制模型服务逻辑的团队。
可部署模型示例:通过 vLLM 部署 Gemma、运行 Llama 3.1-8B 推理,以及部署 Stable Diffusion 等。Modal 没有与托管 MaaS 相同的固定模型目录,实际可运行范围取决于模型权重、代码、依赖和 GPU 配置,示例见(Modal LLM 推理文档)与(GPU 指南)。
如果目标只是用统一 Key 调用多个闭源模型,Modal 通常不是最直接的方案;如果目标是运行开放模型、私有权重或自定义 pipeline,它的价值更容易体现。成本评估需要覆盖计算时长、GPU 类型、并发容器、冷启动和闲置资源,而不是只估算 Token。上线前还应设计模型权重加载、伸缩策略、超时、可观测性和数据持久化,确保 Serverless 的便利不会掩盖实际容量问题。
19. DeepInfra
DeepInfra 官方文档提供 OpenAI 兼容的托管推理,并覆盖私有模型部署、专属 GPU 和集群等路径。它适合希望通过熟悉接口调用开放模型,同时在需要时部署自有模型或扩展到底层资源的团队。相较于纯网关,DeepInfra 更直接地承担模型运行,因此评估重点应包括实际推理服务,而不只是协议转换。
代表模型(非完整清单):Kimi-K3.1-Pro、Kimi-K3、MiMo-V2.6-Flash、Qwen3-TTS、Qwen3-TTS-VoiceDesign,覆盖文本与语音任务;当前模型 ID 和调用方式见(DeepInfra 模型目录)。
对于原型项目,可以先使用托管模型减少部署工作;对于私有模型或持续高负载,再比较专属 GPU 与集群方案。测试时要固定模型、量化与请求参数,观察高峰并发下的延迟和错误率,并核对上下文、工具调用及流式行为。采用专属资源时,应把实例在线时间、扩缩容和冗余副本计入成本,避免用低频 Serverless 的账单逻辑推算常驻服务。
四、第三方 API 中转/聚合平台:统一接入、路由与治理
第三方平台通常位于应用和模型供应商之间,核心价值是减少多套鉴权、SDK、账单与监控的维护工作。对需要频繁比较模型、为不同任务分配模型,或希望保留供应商切换能力的团队,这一层能够显著简化工程实现。部分平台还支持 BYOK,让用户使用自己的供应商密钥,同时获得网关的日志、预算和路由能力。
但“多一层”也意味着新的依赖与责任边界。用户需要弄清楚平台是托管转售、代理转发,还是仅提供控制平面;发生内容错误、上游限流、账单争议或数据事件时,分别由谁负责。高可用、保险或赔付等机制通常也有适用范围和触发条件,应以当前服务条款为准。
20. OpenRouter
OpenRouter 是较典型的统一模型网关,既提供跨模型访问,也提供跨供应商路由。官方资料展示了供应商排序、价格约束和故障转移等机制;此外,供应商故障转移与模型 fallback 不是同一概念,前者可以在同一模型的不同服务提供方之间切换,后者则可能改变实际使用的模型。
代表模型(非完整清单):openai/gpt-6.1-terra、anthropic/claude-fable-5.2、google/gemini-4-carbon、moonshotai/kimi-k3.1-pro、deepseek/deepseek-v4.1-flash-1017、minimax/minimax-m3.1-flash。模型与上游供应商会持续变化,可在(OpenRouter 模型目录)或其(实时模型 API)查询。
这种区分对生产系统非常重要。同一模型跨供应商切换,仍需关注版本、量化、上下文与功能差异;跨模型 fallback 则更可能改变回答风格、工具调用和评测结果。建议为不同任务显式配置允许的路由范围,并在日志中记录实际模型与供应商。对质量敏感的业务,不应让系统在无告警的情况下自动降到未经验证的模型。
21. Vercel AI Gateway
Vercel AI Gateway 官方文档覆盖集中管理凭据、BYOK、请求日志、预算、成本跟踪、供应商故障转移、路由和多模态模型访问。它适合已经使用 Vercel 开发与部署体系,或希望在统一网关中管理多个模型供应商的团队。BYOK 对已有供应商合同和额度的组织尤其有意义,因为网关治理与底层采购可以分开设计。
代表模型(非完整清单):GPT-6-Astra、Claude Opus 5、Claude Fable 5、Gemini 3.6 Flash、Gemini 3.1 Pro Preview、Grok 4.3、GPT-5.5。实际可用模型取决于网关目录、供应商与 BYOK 配置,详见(Vercel AI Gateway 模型与供应商)。
不过,统一账单、平台托管密钥和 BYOK 的成本及责任并不相同,选型时必须先确认采用哪种模式。建议检查日志是否能满足团队归因需求,预算限制是告警还是强制阻断,以及故障转移是否会改变模型或仅改变供应商。对前端直达模型的架构,还应避免把密钥暴露到客户端,并通过服务端身份与权限控制限制滥用。
22. ZenMux
ZenMux 是统一 AI 模型网关,主要用于简化多模型接入,并提供路由和故障转移等能力。它适合希望减少多供应商接入差异、集中管理调用的开发者。模型目录、路由策略和商业功能可能持续调整,接入前可直接查看官网的最新模型与功能说明。
目录中可见的代表模型(非完整清单):GPT-6 Astra、Claude Opus 5.5、Gemini 3.5 Flash、DeepSeek V4.1 Flash、GLM-5.3、Kimi K3、MiniMax-M3.1-Flash、Qwen3.7 Max;模型名称可在(Models.dev 的 ZenMux 目录)交叉查看,实际接入应以(ZenMux 官方模型目录)为准。
如果关注到其保险或赔付类功能,更应阅读适用条件、赔付范围、触发证据和免责条款,不宜将其表述为所有请求都能获得的无条件保障。企业接入还应确认底层供应商透明度、请求日志、数据留存、状态页和支持渠道。对关键业务,最好保留直连或备用网关方案,避免统一入口本身成为新的单点故障。
23. AiHubMix
AiHubMix 提供统一的多模型 API 入口,适合希望减少不同模型适配工作的开发者。对于原型开发、内部工具和多模型对比,它的主要价值是缩短接入时间、集中管理密钥与调用。模型范围、折扣、并发和速率限制可能调整,接入前可查看官网的当前说明。
代表模型(非完整清单):GPT-5.5、GPT-Image-2、Gemini 3.1 Pro、Claude Opus 4.6、GLM-5.1、Nano Banana 2,覆盖文本与图像生成等任务。更多模型和调用说明可查看(AiHubMix 文档)与(模型目录)。
接入前建议用自己的账号完成小规模端到端测试,检查目标模型、协议兼容、工具调用、流式响应、错误码与账单明细是否满足需求。若用于企业业务,还应进一步确认数据处理路径、发票与合同、支持响应和上游供应商政策。对于成本与并发能力,最好结合实际限流、服务形态和总账单验证,判断是否能够满足生产需求。
24. AI/ML API
AI/ML API 官方文档提供统一 API 与持续更新的模型目录,模型类型不局限于文本,也覆盖其他生成式任务。它适合希望在一个开发者入口中试验多类模型的团队,尤其是同时涉及语言与媒体能力的项目。具体模型是否可用、采用何种 endpoint 和参数,应通过其实时模型列表与 API 参考确认。
代表模型(非完整清单):Gemini 4 Carbon、Claude Fable 5.2、GPT-6.1 Terra、Kimi K3.1 Pro、MiniMax M3.1 Flash、GPT Image 2.6 Flare、Kling 4.0 Image to Video。实时模型 API 会按不同 endpoint 重复列出部分模型,因此不能把返回条目数直接当作唯一模型总数;查询入口见(AI/ML API 模型列表)。
由于统一目录可能包含差异很大的模型类型,接入设计应按任务封装,而不是假设所有模型共享同一套输入输出。文本任务关注消息、工具和结构化输出,媒体任务则要处理文件、异步状态与产物保存。生产选型还需核查价格单位、速率限制、区域和数据政策,并为关键模型准备退出或替代路径,避免目录变化直接影响业务。
25. TokenDance(词元跳动)
TokenDance(词元跳动)官方页面展示了 OpenAI、Claude、Gemini 等协议兼容,以及统一计费、模型路由和 fallback 等能力。它适合希望在保留既有客户端或 SDK 习惯的同时,统一接入不同模型生态的用户。多协议支持能够减少部分改造,但仍需分别验证各协议的高级字段、流式行为与错误处理。
代表模型(非完整清单):Kimi K3.1 Pro、DeepSeek V4.1 Flash 1017、MiniMax M3.1 Flash、Hy4、Qwen3.8 Max、Kling Video 4.0、Qwen-Image-2.1-Pro。模型接口可能保留旧条目,是否已下线还应结合(TokenDance 模型说明)与(更新日志)判断。
选型时应把“协议兼容”和“行为一致”分开验收。同一套工具调用或结构化输出请求,在不同模型与上游服务上可能得到不同结果;fallback 也可能改变成本和质量。建议记录实际路由结果,给关键任务设置允许切换的模型白名单,并确认余额、账单、限流和日志能否满足团队对账与排障要求。
五、25 个 AI 大模型聚合平台对比表
下表用于快速缩小候选范围,而不是给出统一排名。“更适合”表示平台核心能力与该场景的匹配方向,并不排除其他用途;同一平台的不同产品、区域和账户等级也可能存在差异。正式决策时,建议先选两至四个候选,再用同一批真实业务样本做质量和压力测试。
| 类别 | 平台 | 核心定位 | 更适合的场景 | 选型时重点核查 |
|---|---|---|---|---|
| 云厂商 | 阿里云百炼 | 模型服务与 AI 应用开发 | 阿里云生态、RAG/Agent 应用 | 模型与区域、权限、应用组件绑定 |
| 云厂商 | 火山方舟 | 一站式大模型平台 | 火山引擎生态、模型到应用交付 | 工具链、配额、跨云迁移 |
| 云厂商 | 腾讯云 TokenHub | 多模型聚合与协议兼容 | 腾讯云用户、多模型统一接入 | 高级字段兼容、错误码、上游策略 |
| 云厂商 | 百度千帆 | 模型、RAG 与 Agent 开发 | 企业知识库和应用构建 | 数据权限、评测、组件成本 |
| 云厂商 | Amazon Bedrock | 托管多模型服务 | AWS 企业工作负载 | 区域、模型访问、吞吐与数据驻留 |
| 云厂商 | Google Cloud Gemini Enterprise Agent Platform | 模型、ML 与企业 Agent 平台 | Google Cloud 与 Agent 技术栈 | 新旧名称、SDK、模型版本与治理 |
| 云厂商 | Microsoft Foundry | 模型、Agent 与企业治理 | Azure 和微软企业生态 | RBAC、网络、项目隔离、评测 |
| 云厂商 | Cloudflare AI Gateway | AI 请求网关与流量治理 | 缓存、限流、支出和请求观测 | 是否需自备模型服务、日志与缓存语义 |
| 云厂商 | UCloud AstraFlow 星图 | 统一 Key 与多模态模型接入 | 国内云服务、多模态调用 | 异步任务、文件生命周期、模态差异 |
| 推理厂商 | NVIDIA NIM APIs | 优化推理微服务与标准 API | 自托管、私有 GPU、标准化推理 | 硬件条件、许可、容量与运维 |
| 推理厂商 | 无问芯穹 | 异构算力与企业级 MaaS | 国产异构、企业基础设施与行业交付 | 服务开放范围、部署边界、SLA |
| 推理厂商 | 硅基流动 SiliconFlow | 模型 API 与推理部署 | 开放模型调用、专属或私有部署 | 模型版本、量化、限流与服务形态 |
| 推理厂商 | Baseten | 托管模型 API、专属推理与训练 | 私有 checkpoint、自定义生产模型 | 副本、冷启动、伸缩与发布 |
| 推理厂商 | Fireworks AI | 开放模型推理、训练与部署 | Serverless 到生产部署 | 吞吐、功能兼容、模式间成本 |
| 推理厂商 | Together AI | 开放权重模型推理与微调 | 开放模型试验、微调和扩展 | 模型可用形态、权重迁移、限流 |
| 推理厂商 | fal | 生成式媒体推理 | 图像、视频、音频与 3D | 排队、异步任务、产物存储与计费单位 |
| 推理厂商 | Novita AI | 多模态 API、专属部署与沙箱 | 媒体生成、Agent 执行、专属资源 | 产品边界、沙箱隔离、文件策略 |
| 推理厂商 | Modal | 代码优先的 Serverless AI 计算 | 自定义推理、训练和批处理 | GPU 时长、冷启动、持久化与工程能力 |
| 推理厂商 | DeepInfra | 托管推理与私有模型部署 | 开放模型 API、专属 GPU/集群 | 并发、上下文、常驻资源成本 |
| API 聚合 | OpenRouter | 跨模型与跨供应商统一网关 | 多模型试验、供应商路由 | 实际路由、provider failover 与模型 fallback |
| API 聚合 | Vercel AI Gateway | 凭据、预算、日志与故障转移 | Vercel 技术栈、BYOK、多供应商治理 | 计费模式、预算执行方式、日志归因 |
| API 聚合 | ZenMux | 统一模型网关与路由 | 多模型接入和容错 | 上游透明度、条款、数据与支持 |
| API 聚合 | AiHubMix | 统一多模型 API 入口 | 原型、内部工具、多模型对比 | 实时模型、限流、账单与企业条款 |
| API 聚合 | AI/ML API | 统一多类型模型 API | 文本与媒体模型的一站式试验 | 不同模态参数、价格单位、速率限制 |
| API 聚合 | TokenDance(词元跳动) | 多协议接入、路由与统一计费 | 兼容既有客户端、多模型 fallback | 协议行为差异、路由记录与对账 |
六、AI 大模型聚合平台怎么选?按场景缩小范围
选择平台的第一步不是列模型数量,而是回答三个问题:模型由谁运行、请求由谁治理、数据在哪里处理。如果只需要一个稳定的官方模型,直连官方 API 往往更简单;如果需要多个模型和统一治理,网关更有价值;如果要运行私有权重,则应优先选择推理与部署平台。把这三件事混在一起,是很多选型对比看似详细、实际无法落地的根源。
还要考虑团队能否承担运维。自托管并不天然更便宜,专属 GPU 也不天然更快;它们只是把更多控制权和责任交给用户。小团队通常应优先减少工程复杂度,大团队则更关注权限、审计、成本归因和跨区域高可用。下面的场景表可以作为第一轮筛选,但不应代替真实业务测试。
| 主要需求 | 优先考察类别 | 可从哪些平台开始验证 | 选择理由 |
|---|---|---|---|
| 企业知识库、RAG、内部 Agent | 传统云厂商 | 百炼、千帆、Bedrock、Microsoft Foundry、Google Cloud Agent Platform | 模型与企业数据、权限、评测和云治理更容易形成闭环 |
| 已深度使用某一朵云 | 对应云厂商 | 阿里云、火山引擎、腾讯云、AWS、Google Cloud、Microsoft | 减少跨云链路和采购割裂,但需评估绑定程度 |
| 快速比较多个文本模型 | 第三方 API 聚合 | OpenRouter、Vercel AI Gateway、AiHubMix、AI/ML API、TokenDance、ZenMux | 统一接入和切换成本较低,适合原型与多模型策略 |
| 已有多个官方密钥,只想集中治理 | 支持 BYOK 的网关 | Vercel AI Gateway 等 | 保留既有供应商关系,同时增加日志、预算和路由控制 |
| 部署开源权重或微调模型 | AI 推理厂商 | Baseten、Fireworks AI、Together AI、DeepInfra、SiliconFlow | 提供模型运行、扩缩容和专属部署路径 |
| 私有 GPU 或自托管推理 | 推理微服务/基础设施 | NVIDIA NIM、无问芯穹及其他支持私有部署的平台 | 更重视环境控制、异构资源与部署边界 |
| 图像、视频、音频或 3D 生成 | 生成式媒体推理 | fal、Novita AI,以及覆盖相应模态的平台 | 媒体任务需要异步工作流和专用模型,不只是文本接口 |
| 自定义 AI pipeline 与弹性计算 | Serverless AI 计算 | Modal,以及其他支持自定义部署的平台 | 可控制代码、依赖和模型服务逻辑 |
| 多云容灾与成本归因 | 网关加底层推理组合 | OpenRouter、Vercel AI Gateway 或云网关搭配直连服务 | 将模型选择与供应商选择分开,便于路由和观测 |
场景一:企业应用与合规治理
企业知识库、客服和内部 Agent 通常不仅调用模型,还要访问文档、数据库和业务系统。此时,云平台的价值主要来自统一身份、网络隔离、权限、审计、评测和应用组件,而不是模型列表本身。选型应先确认数据和系统的位置,再判断同云集成是否能降低复杂度;如果关键数据在本地或另一朵云,还要把跨域传输和访问控制纳入设计。
第三方网关仍可作为补充,用于多模型试验或跨供应商容灾,但不应绕过企业安全审查。推荐架构是把网关放在受控服务端,统一密钥、配额、日志和路由,同时禁止客户端直接持有供应商密钥。对敏感数据,需分别核查网关与底层模型的数据政策,因为网关不留存并不代表上游也不留存,反之亦然。
场景二:开源模型、自定义模型与高并发推理
当模型权重、推理参数或服务性能是核心竞争力时,推理厂商通常比纯中转平台更合适。团队可以先用 Serverless 验证模型,再根据流量曲线决定是否转向专属部署。持续高负载可能适合常驻资源,波动流量则更看重弹性;如果涉及自研模型、复杂前后处理或私有 checkpoint,还需要确认平台能否承载自定义代码和依赖。
性能比较必须使用可复现的测试条件。至少固定模型权重、量化方式、输入输出长度、并发、流式设置和工具调用,再分别测量首 Token 延迟、生成速度、端到端延迟和失败率。高可用测试还要包含限流、上游超时和节点异常,并确认扩容或备用副本是否真正生效。只有在相同条件下,价格和性能才具有可比性。
场景三:多模型试验、路由与供应商切换
多模型应用可以把简单分类、摘要和复杂推理分配给不同模型,但路由策略必须受质量约束。建议先建立任务级评测集,定义哪些模型可作为主模型、哪些可作为备选,以及允许切换的供应商范围。供应商 failover 主要解决同一模型的服务可用性,模型 fallback 则改变能力来源;后者的质量与成本风险通常更大,需要更严格的告警和评测。
对原型团队,统一 API 能显著减少接入时间;对生产团队,真正重要的是能否还原每一次请求的实际路径。日志至少应记录应用、用户或租户、请求模型、实际模型、实际供应商、Token、费用、延迟和错误类型。没有这些字段,所谓智能路由可能让成本和质量变得不可解释,也会增加后续迁移难度。
场景四:生成式图像、视频与音频
媒体生成任务的工作流与文本聊天明显不同,通常包含素材上传、异步排队、任务状态查询、Webhook、结果下载和内容审核。选型时应优先确认目标模型和工作流是否匹配,再比较生成质量和任务稳定性。对于视频等长任务,排队时间和失败恢复可能比接口平均响应更重要,产物的存储与访问权限也会直接影响用户体验。
成本应按一次成功生成或可交付结果计算,而不是只看页面标价。失败任务是否计费、重试是否重复收费、不同分辨率或时长如何计价,都应进入测试表。若业务允许用户上传人像、商标或内部素材,还需核查内容政策、数据保留和删除机制。文本模型选型中的 Token 成本公式,不能直接套用到所有媒体模型。
七、成本、安全与可迁移性:上线前必须核查的清单
1. 用总拥有成本替代“每百万 Token 最低价”
文本模型的基础成本可以拆成输入、输出、缓存读写和平台附加费用,但真实账单还可能包含专属实例、GPU 在线时长、网络传输、文件存储、向量检索、日志、评测和冗余副本。对 Agent 应用,模型会多次调用工具并反复携带上下文,单轮请求价格无法代表一次任务成本。更合理的指标是每个成功任务的总成本,并把失败重试和无效输出计算在内。
建议用低、中、高三种流量情景做月度测算,同时模拟上下文增长和输出长度变化。Serverless 要核查最小计费单位与限流,专属部署要核查最小副本、缩容到零和冗余成本,网关则要确认是否加收服务费以及 BYOK 如何收费。价格与配额可能调整,采购时应以实时价格页为准,并记录测算日期。
2. 把数据处理链路画完整
安全审查不能只问“平台是否安全”,而要画出应用、网关、模型供应商、日志系统、缓存和文件存储之间的数据流。逐段确认传输加密、密钥管理、访问权限、请求与响应留存、训练使用政策、删除机制和区域。对于 BYOK,也要明确密钥由谁保管、员工能否导出,以及撤销密钥后网关如何处理正在运行的请求。
企业还应准备合同和事故处理层面的答案,包括服务主体、数据处理协议、分包商、支持渠道、状态通知、SLA 与赔偿边界。如果平台只提供转发,底层供应商条款可能仍然适用;如果平台转售模型服务,则需确认责任如何划分。对隐私、医疗、金融或其他受监管数据,应由企业安全与法务团队按自身适用规则完成审查,不能仅依据平台的一般性说明作出判断。
3. 验证兼容性,而不是只看“OpenAI-compatible”
OpenAI 兼容通常能降低 SDK 和基础请求改造的门槛,但不同平台对工具调用、结构化输出、多模态输入、流式事件、缓存、错误码和用量字段的支持可能不同。Anthropic 或其他协议兼容也存在同类问题。接入验收应覆盖应用真正使用的字段,并测试异常路径,不能只发送一条普通聊天请求就宣布迁移完成。
为避免锁定,可在业务层定义内部统一的模型调用接口,把平台专属参数隔离在适配器中。提示词、工具 schema、模型名和路由规则应可配置,日志中保留原始供应商标识。对于关键任务,还应保留一组可跨平台运行的回归测试,确保更换供应商后能立即判断质量和功能是否退化。
4. 为故障、限流与退出提前设计路径
高可用不只是“平台有 fallback”这一项功能。团队需要决定什么错误触发重试、重试几次、是否保持幂等、何时切换供应商、何时切换模型,以及所有路径失败时如何向用户降级。流式响应中途失败、工具调用部分完成和异步媒体任务超时,都需要单独策略,否则自动重试可能造成重复操作或重复费用。
退出方案同样重要。应确认能否导出配置、日志和微调产物,模型权重是否可迁移,域名与密钥如何更换,以及备用直连通道多久能启用。对核心生产系统,建议至少每半年进行一次切换演练。聚合平台的价值应是让切换更容易,而不是用更多专属功能把切换变得更困难。
八、建议的概念验证测试表
一个有效 POC 不需要一开始覆盖全部平台,而应选择少量候选,在相同样本和负载下比较。测试集应来自真实业务,并包含正常样本、长上下文、边界条件、敏感内容和容易失败的工具调用。除了平均分,还要记录最坏情况和人工复核成本,因为少量严重错误可能比整体延迟更容易决定能否上线。
下表可直接复制到内部评测文档。质量指标应按任务定义,例如摘要的事实一致性、客服的解决率、代码任务的测试通过率或结构化抽取的字段准确率;不要用一个通用分数替代所有业务判断。性能与成本也应按成功任务统计,避免把失败请求当作“低成本”。
| 测试维度 | 必测项目 | 建议记录字段 |
|---|---|---|
| 输出质量 | 固定评测集、人工盲评、工具调用、结构化输出 | 通过率、严重错误、人工复核时间 |
| 性能 | 首 Token、生成速度、端到端延迟、并发压力 | P50/P95/P99、吞吐、超时率 |
| 兼容性 | 流式、工具、JSON、多模态、错误码 | 支持字段、异常行为、所需改造量 |
| 稳定性 | 限流、上游故障、重试、fallback | 实际路由、恢复时间、重复请求 |
| 成本 | 输入输出、缓存、重试、专属资源、平台费用 | 每千次成功任务成本、月度三档测算 |
| 安全 | 数据留存、权限、日志、区域、删除 | 数据流、责任人、保留期限、审计证据 |
| 运维 | 监控、告警、账单、状态页、支持 | 排障时间、归因字段、支持响应 |
| 退出 | 配置导出、权重迁移、备用通道 | 切换步骤、预计耗时、回归测试结果 |
九、AI 大模型聚合平台常见问题 FAQ
AI 大模型聚合平台哪个好?
没有脱离场景的“最好”。已有云生态、重视 RAG 与治理的企业,可优先筛选相应云厂商;运行开源或私有模型,可优先筛选推理平台;需要快速接入多个模型和统一路由,则可优先筛选第三方网关。先把候选缩到两至四个,再用同一评测集比较,比按模型总数或页面标价排名更可靠。
如果一定要给出单一结论,也应附带约束条件,例如“适合 AWS 上企业 Agent”“适合生成式媒体原型”或“适合自带密钥的多供应商治理”。平台的核心定位不同,直接做总榜容易把不同产品混在一起。对生产项目,质量、稳定性、安全和退出成本通常比短期接入速度更重要。
大模型 API 聚合平台和 API 中转是一回事吗?
不完全是。API 中转通常强调把请求转发到一个或多个上游接口,而聚合平台还可能提供模型目录、统一计费、路由、预算、缓存、日志和故障转移。云厂商的 MaaS 与推理平台甚至会直接运行模型,这已经超出狭义中转的范围。因此,“聚合”是较宽泛的说法,具体产品必须看其服务边界。
判断时可以问:模型由谁运行,费用由谁收取,数据经过哪些主体,故障由谁负责。如果平台只做协议转换,就不要默认它提供底层 SLA;如果平台直接提供推理,则要评估模型版本、硬件和扩容能力。把这些问题写进对比表,比仅记录“支持多少模型”更有意义。
传统云厂商和第三方 API 聚合平台怎么选?
云厂商更适合需要云上数据、身份权限、私有网络、RAG、Agent 和企业采购的一体化项目。第三方平台更适合多模型试验、跨供应商路由和减少接入维护。两者并非互斥,企业可以在云内运行主业务,同时通过受控网关接入补充模型,但要避免重复日志和不受控的数据路径。
最终选择取决于主要矛盾:如果问题是企业系统整合和治理,先看云;如果问题是模型与供应商切换,先看网关;如果问题是私有模型的运行性能,则应看推理平台。不要仅因第三方接入更快,就跳过安全和责任边界审查,也不要仅因云平台功能完整,就接受不必要的复杂度。
OpenAI-compatible 是否意味着可以无缝切换所有模型?
不是。它通常表示基础 API 路径或请求格式与 OpenAI 生态兼容,有助于复用 SDK,但不保证工具调用、结构化输出、多模态、流式事件和错误码完全一致。模型本身的行为差异也不会因协议兼容消失。尤其是复杂 Agent,切换后必须重新测试工具链和异常处理。
建议把兼容验收分成基础对话、流式输出、工具调用、结构化输出、用量统计和错误处理六组测试。对于 fallback,还要重新运行质量评测,因为即便接口无需修改,回答质量和成本也可能变化。协议兼容降低的是接入成本,不是全部迁移成本。
BYOK 有什么用?
BYOK 即 Bring Your Own Key,用户把自己的模型供应商密钥接入网关,由网关提供统一路由、日志、预算或其他治理功能。这样既能保留已有供应商合同、额度或折扣,也能减少每个应用分别管理密钥的混乱。对已有多个官方账号的团队,BYOK 往往比重新采购一套转售额度更灵活。
但 BYOK 不代表没有平台费用,也不代表数据不经过网关。用户仍需确认密钥存储、日志、平台服务费、限流和撤销机制。如果网关宕机,是否可以直接使用原供应商密钥切换回官方 API,也应纳入退出演练。
provider failover 和 model fallback 有什么区别?
provider failover 通常指同一模型在不同推理供应商之间切换,主要解决供应商故障、容量或限流问题。model fallback 则是切换到另一个模型,可能影响能力、风格、工具调用、上下文和价格。OpenRouter 的官方路由资料也把供应商路由与模型回退作为不同机制呈现(OpenRouter)。
生产配置中,两者都应显式记录并告警。前者仍需验证同一模型在不同供应商上的版本和量化差异,后者则应使用预先批准的备选模型列表。对医疗、金融、法律或其他高风险输出,不应让未经验证的模型在无人知晓的情况下自动接管请求。
使用聚合平台是否一定比官方 API 便宜?
不一定。聚合平台可能通过统一采购、路由、缓存或不同推理供应商提供成本选择,也可能收取服务费或采用不同计费口径。官方 API 则减少中间层,责任链更直接。真正应比较的是完成同一任务的总成本,包括输出质量导致的重试、上下文、工具调用、平台费用和运维成本。
低价还可能对应不同模型版本、量化、服务等级或使用限制。建议按“每千次成功任务成本”而不是“每百万 Token 标价”做 POC,并把失败请求和人工复核计入。对于波动流量和常驻流量,也应分别测算 Serverless 与专属资源,避免用单一单价做全年预算。
小团队是否有必要使用聚合平台?
如果只使用一个模型、流量较小且没有复杂治理需求,直连官方 API 通常更简单,故障链也更短。小团队需要频繁比较多模型、使用不同模态,或希望减少多平台密钥与账单管理时,聚合平台才更有明显价值。选择的标准应是节省的工程和试错成本,而不是功能列表看起来是否强大。
随着项目成长,可以先在代码中保留轻量适配层,不必一开始就部署复杂网关。等出现多团队用量归因、供应商容灾、私有模型或严格预算需求,再引入相应平台。这样既能保持原型速度,也能避免过早承担不必要的平台依赖。
如何避免被某个聚合平台锁定?
在业务代码与平台之间保留内部接口,把模型名、提示词、工具定义和路由规则配置化,避免直接散落平台专属参数。日志中记录实际模型和供应商,并维护一套可跨平台运行的回归测试。对于微调或私有模型,还要提前确认权重、配置和产物能否导出。
同时准备至少一条备用路径,可以是官方 API 直连、另一个网关或可替代的推理服务。备用方案需要定期演练,而不是只写在架构图上。如果切换时需要重新开发全部工具链或无法还原历史账单,那么所谓的多模型聚合仍可能形成事实锁定。
十、总结:先选服务层级,再选具体平台
AI 大模型聚合平台的 25 个候选,实际上对应三种不同采购对象:传统云厂商交付的是模型与企业应用平台,AI 算力/推理厂商交付的是模型运行与部署能力,第三方 API 中转/聚合平台交付的是统一接入和流量治理。先确定自己需要哪一层,再比较模型、质量、延迟、稳定性、总成本、安全和退出能力,才能形成有效选型。
对大多数团队,合理流程是“真实任务评测—小规模 POC—安全与条款审查—三档流量成本测算—故障与退出演练”,而不是先接入再补治理。平台模型目录和商业条款会持续变化,以上平台可以作为候选清单;最终上线决策应以最新文档、合同以及自己的实测结果为依据。
以上内容仅供产品与技术选型参考,不构成对任何平台服务质量、价格持续有效或特定合规结果的保证,也不替代企业自身的安全、法务与采购审查。